بسم الله الرحمن الرحيم.
بعد انتهاء الموضوعات الخاصة بالـ CPU في الدروس الثلاثة الأخيرة، سننتقل بإذن الله إلى موضوعات الذاكرة — وهي لا تقل أهمية عن ما سبقها.
تنقسم موضوعات الذاكرة إلى ثلاثة محاور: (Virtual Memory، Cache Memory، Internal Memory). وقد سبق أن تناولنا الذاكرة الافتراضية من زاوية عملية ضمن درس الذاكرة الافتراضية في ورشة لغة C، وموضوع اليوم هو الذاكرة المخبئية.
نظرة عامة على الذاكرة المخبئية (Cache Memory Overview)
الذاكرة المخبئية: مخزن صغير وعالي السرعة يقع عادة بين المعالج CPU والذاكرة الرئيسية RAM. وظيفتها تخزين نسخ من البيانات والتعليمات الأكثر استخداماً، بحيث يتمكن المعالج من الوصول إليها بسرعة.
تُبنى الذاكرة المخبئية عادةً من نوع SRAM — أسرع بكثير من ذاكرة النظام DRAM — ولذلك فهي أصغر حجماً وأعلى تكلفة.
عند طلب المعالج بيانات ما، يُفحص الكاش أولاً: فإن كانت البيانات موجودة فهذه حالة إصابة (Cache Hit) ويتم الوصول إليها في زمن قصير جداً، وإلا فهي حالة إخفاق (Cache Miss)، فيتم جلب البيانات الأبطأ من الذاكرة الرئيسية RAM وتخزينها في الكاش لاستخدامها مستقبلاً.
من أهم مزايا الكاش أنه يقلل متوسط زمن الوصول إلى الذاكرة (Average Memory Access Time) بفضل استغلال مبدأ المحلية (Locality of Reference) في البرامج — أي ميل البرنامج إلى إعادة استخدام البيانات أو التعليمات نفسها، أو بيانات قريبة من الموقع الذي يتم الوصول إليه حالياً. عندئذ تكون عملية التخزين المؤقت Caching فعالة وسريعة.
مبدأ عمل الكاش (Cache Principle)
تعتمد كفاءة الكاش على نسبة الإصابات (Hit Ratio) ونسبة الإخفاقات (Miss Ratio): عند كل طلب ذاكرة، إذا وُجدت البيانات في الكاش أطلقنا عليها Cache Hit، وإلا فهي Cache Miss.
معادلة زمن الوصول المتوسط
AMAT = T(hit) + Miss Ratio × T(penalty)
حيث:
- AMAT: متوسط زمن الوصول إلى الذاكرة.
- T(hit): زمن الوصول عندما تكون البيانات موجودة في الكاش.
- Miss Ratio: نسبة الإخفاقات (ما لم تجد في الكاش).
- T(penalty): العقوبة الإضافية عند الإخفاق — أي الزمن الإضافي لجلب البيانات من الذاكرة الرئيسية.
مثال رقمي: إذا كان T(hit) = 1ns والعقوبة T(penalty) = 100ns ونسبة الإخفاق 2%:
AMAT = 1 + 0.02 × 100 = 3ns
لاحظ كيف أن نسبة إصابة مرتفعة تُبقي المتوسط قريباً من زمن الكاش نفسه رغم بطء الذاكرة الرئيسية. ومن العوامل المؤثرة في تحسين النسبة: زيادة حجم الكاش، وحجم الكتل (Lines/Blocks)، ودرجة الترابط (Associativity) — وكلها تهدف إلى تقليل الإخفاقات وتحسين الأداء.
اختبار سريع
كان
T(hit) = 2ns والعقوبةT(penalty) = 80ns ونسبة الإخفاق 5% — احسب زمن الوصول الفعال بنفسك قبل تكملة القراءة.
الحل (اضغط للعرض)
AMAT = 2 + 0.05 × 80 = 6ns
لاحظ أن 5% إخفاقاً فقط ضاعفت الزمن ثلاث مرات تقريباً — هذا هو صراع الكاش كله في سطر واحد.
يكون الكاش عادة متدرجاً بالمستويات (L1، L2، L3):
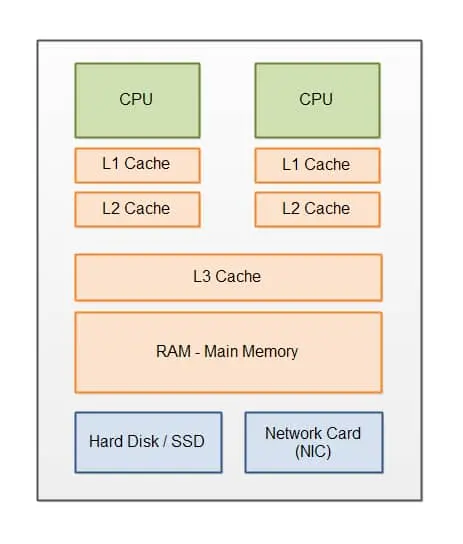 شكل (1): التسلسل الهرمي للذاكرة المخبئية
حيث يكون L1 أقرب المعالج وأسرعها وأصغرها، ثم يليه L2 فL3؛ كل مستوى أعلى أكبر حجماً وأبطأ نسبياً. وتستفيد البرامج من وجود الكاش عبر المحلية الزمنية والمكانية — أي أننا نتوقع أن البيانات أو التعليمات المطلوبة قريبة مما استُخدم للتو.
مبدأ المحلية (Locality of Reference)
مبدأ المحلية يعني أن البرنامج يميل إلى الوصول إلى المنطقة نفسها في الذاكرة أو مناطق قريبة منها خلال فترة قصيرة. ولنفهمنها بتشبيه: موظف توصيل طلبات يحب توصيل الطلبات للأماكن التي راح إليها سابقاً، وبالوقت ذاته يأخذ الطلبات القريبة من بعضها حتى يوصلها جميعاً معاً.
للمحلية نوعان رئيسيان:
• المحلية الزمانية (Temporal Locality): البيانات أو التعليمات التي تم الوصول إليها مؤخراً يُرجَّح الوصول إليها مرة أخرى قريباً. مثلاً إذا كانت دالة تنفذ حلقة على مصفوفة، فمن المرجح أن يعود المعالج إلى العناصر نفسها أكثر من مرة.
• المحلية المكانية (Spatial Locality): إذا وصل البرنامج إلى موقع ذاكرة معين، فغالباً سيستخدم عناوين قريبة منه أيضاً. فعند قراءة مصفوفة بترتيب متسلسل يشير العنوان الحالي إلى بلوك ذاكرة، والعناوين المجاورة في البلوك نفسه ستُخزن في الكاش معه.
مثال:
// مصفوفة بترتيب متتابع
for (int i = 0; i < N; i++) {
    sum += A[i];
}

// مصفوفة بترتيب عشوائي
for (int i = 0; i < N; i++) {
    int idx = rand() % N;
    sum += A[idx];
}
في الحلقة الأولى يتم الوصول إلى عناصر متجاورة من المصفوفة، مما يستفيد من المحلية المكانية ويرفع نسبة Cache Hits. أما الحلقة الثانية فتصل عشوائياً عبر rand، مما يزيد عدد Cache Misses.
اختبار سريع
مصفوفة ثنائية الأبعاد
int M[1024][1024]— أي الحلقتين ينهي أسرع ولماذا؟/* A */ /* B */ for (i = 0; i < 1024; i++) for (j = 0; j < 1024; j++) for (j = 0; j < 1024; j++) for (i = 0; i < 1024; i++) s += M[i][j]; s += M[j][i];
الحل (اضغط للعرض)
الحلقة A أسرع بكثير. تمسح A الذاكرة بالترتيب المتجاور فتستغل المحلية المكانية: كل بلوك يجلبه الكاش — 64 بايتاً عادة، أي 16 عدداً صحيحاً — يُستهلك كاملاً قبل الانتقال لغيره. أما B فتقفز بمقدار 4KB في كل خطوة، فتضيع البلوك كاملاً بعد استخدام عنصر واحد منه: إخفاق لكل وصول تقريباً.
تقنيات الربط (Mapping Techniques)
كيف يتم الربط بين الذاكرة الرئيسية Main Memory والذاكرة المخبئية Cache؟ عبر مفهوم يسمى تقنيات الربط (Mapping Techniques):
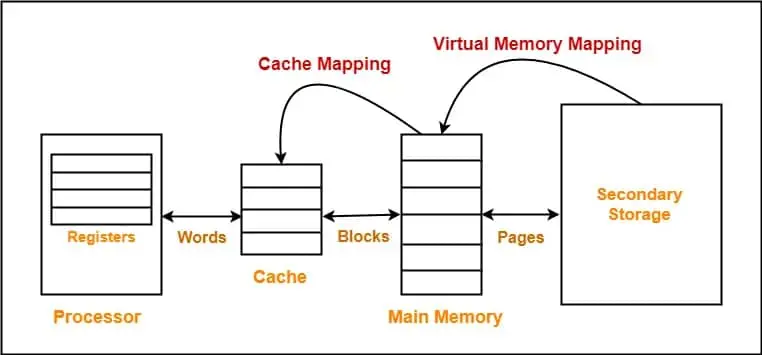 شكل (2): تقنيات الربط بين الذاكرة الرئيسية والكاش
عند نقل البيانات من الذاكرة الرئيسية إلى الكاش تُستخدم إحدى التقنيات التالية:
الربط المباشر (Direct Mapping)
كل بلوك من الذاكرة الرئيسية يُفهرس إلى خانة وحيدة محددة في الكاش (إذا تم الوصول إلى بلوكين يشتركان في الفهرس Index نفسه، فإن أحدهما يحل محل الآخر ويحدث تصادم Conflict).
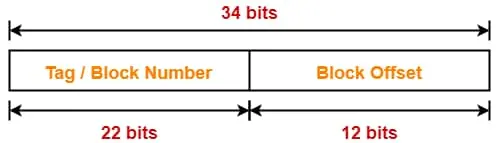
في هذه التقنية يُقسم عنوان الذاكرة إلى حقول: (Offset، Index، Tag):
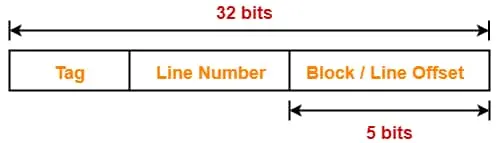 شكل (3): تقسيم العنوان في الربط المباشر
- Index: لتحديد رقم سطر الكاش المرشح.
- Tag: إن لم يتطابق مع العلامة المخزنة حدث Cache Miss ويستبدل السطر الحالي.
- Offset: إزاحة تحدد موقع البايت داخل البلوك:
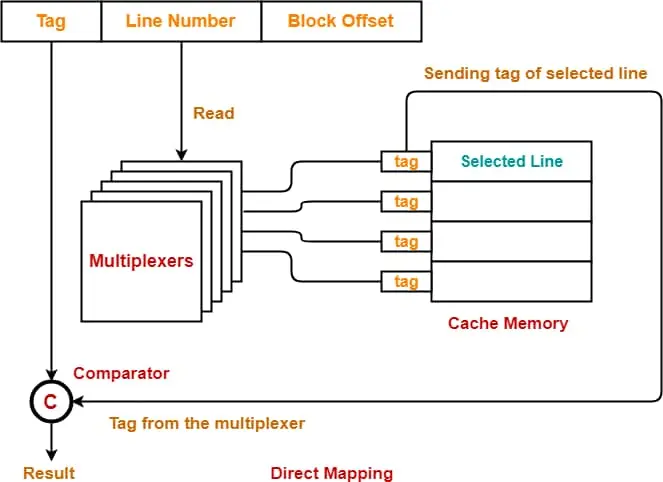 شكل (4): الإزاحة داخل البلوك
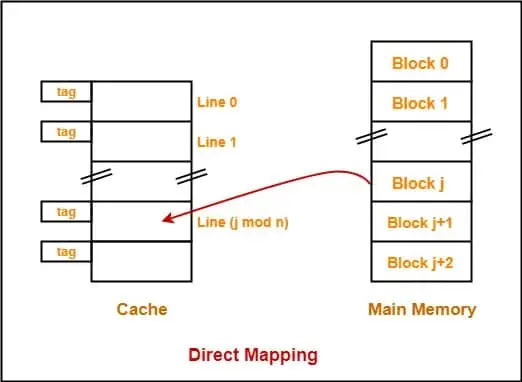 شكل (5): مثال تطبيقي على الربط المباشر
المزايا: بسيط التنفيذ، ومنطق تحكم Logic بسيط مما يعطي زمن وصول منخفضاً.
العيوب: احتمال التصادم كبير إذا صادفت عدة كتل الفهرس نفسه، فقد يرتفع معدل الإخفاق Miss Rate، والدعم للمحلية المكانية ضعيف.
الربط الكامل (Fully Associative)
يمكن لأي بلوك من الذاكرة أن يستقر في أي خانة من الكاش لأنه لا يوجد فهرس، ويقسم عنوان الذاكرة هنا إلى (Tag، Offset) فقط:
 شكل (6): تقسيم العنوان في الربط الكامل
وعند البحث عن كتلة في الكاش تُقارن الـ Tag مع جميع الأسطر حتى العثور على التطابق:
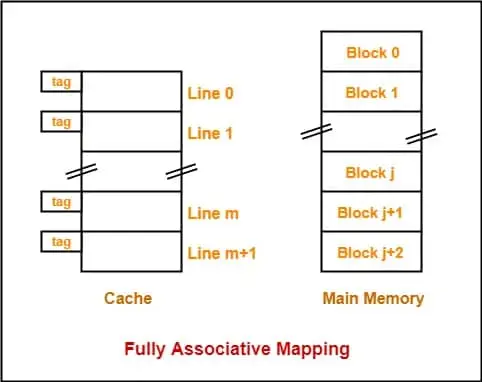 شكل (7): مثال تطبيقي على الربط الكامل
المزايا: مرونة عالية، ويحل مشكلة التصادم Conflict.
العيوب: باهظ الثمن من ناحية العتاد (مقارنة متزامنة مع كل الأسطر).
الربط المجموعاتي (Set Associative)
هذا هو الحل الوسط بين المباشر والكامل: تقسم ذاكرة الكاش إلى مجموعات Sets، بحيث تحتوي كل مجموعة Set على عدد L من الأسطر Lines. يُستخدم حقل من العنوان لتحديد المجموعة (كما في الربط المباشر)، ثم يمكن لأي سطر داخل تلك المجموعة تخزين البيانات:
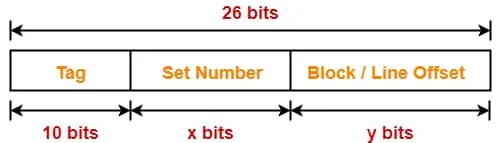 شكل (8): تقسيم العنوان في الربط المجموعاتي
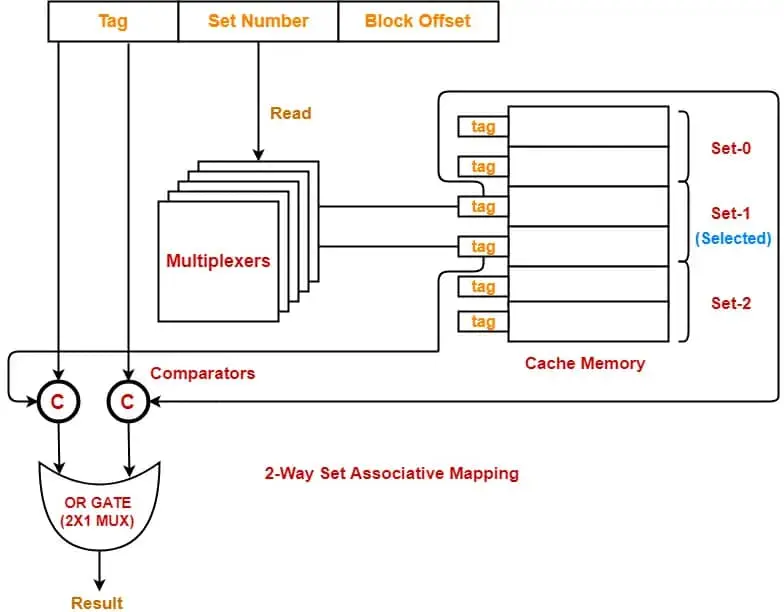 شكل (9): بنية المجموعات والأسطر
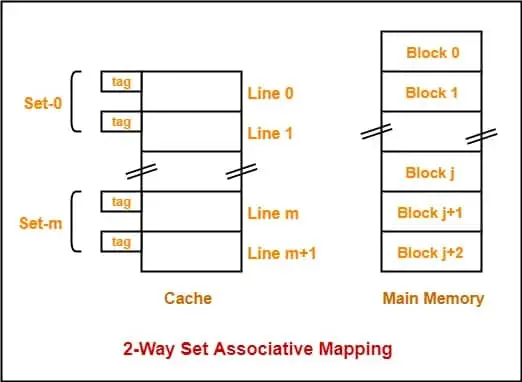 شكل (10): مثال تطبيقي على الربط المجموعاتي
المزايا: يجمع بين سرعة المباشر ومرونة الكامل.
العيوب: أغلى وأعقد من الربط المباشر.
عناصر تصميم الكاش (Elements of Cache Design)
يتحدد تصميم الكاش بعدة معطيات أساسية: سعة الكاش (Cache Size)، وحجم الكتلة (Block/Line Size)، ودرجة الترابط (Associativity)، وعدد المجموعات (Sets)، بالإضافة إلى سياسة الاستبدال وسياسة الكتابة.
وتُحسب سعة الكاش بالمعادلة:
Cache Size = Sets × Block Size × Associativity
ويقسم عنوان الذاكرة إلى ثلاثة أجزاء:
- Offset: لتحديد البايت داخل البلوك.
- Index: لتحديد رقم السطر أو المجموعة.
- Tag: لتحديد أي بلوك من الذاكرة الرئيسية هو المقصود.
وهذا التقسيم يسمح بالبحث السريع في جدول الكاش.
سياسة الاستبدال (Replacement Policy)
عند امتلاء مجموعة في الكاش والحاجة لإدخال بلوك جديد، يجب اختيار بلوك قديم لحذفه. سياسة الاستبدال هي التي تحدد أي بلوك سيزال. أهم السياسات:
• Least Recently Used (LRU): تزيح البلوك الأقل استخداماً منذ أطول زمن. تتطلب تتبع استخدام الأسطر (بتخزين معلومات عمرية)، وهي فعالة لكنها معقدة من ناحية العتاد.
• First-In First-Out (FIFO): قائمة انتظار كالطابور؛ تزيح الكتلة الأقدم دخولاً بغض النظر عن مدى تكرار استخدامها.
• Random: تختار خانة عشوائية للحذف، وتتميز بسهولة وسرعة التنفيذ.
كل سياسة استبدال هي تسوية بين معدل الإصابات وزمن اتخاذ القرار؛ فـ LRU مثلاً قد يرفع معدل الإصابات لكنه يحتاج ذاكرة إضافية لتعقب الأعمار.
سياسات الكتابة (Write Policies)
عند كتابة بيانات إلى عنوان موجود في الكاش، توجد سياسات رئيسية تحدد كيفية تحديث الذاكرة:
• الكتابة الفورية (Write-Through): تكتب البيانات في الكاش وفي الذاكرة الرئيسية معاً في آنٍ واحد، مما يضمن تزامن النسختين ويحافظ على اتساق أعلى — ولكن بزمن كتابة أطول لأن البيانات تكتب مرتين.
• الكتابة المؤجلة (Write-Back): تكتب البيانات أولاً في الكاش فقط، وتوضع علامة (Dirty Bit) على الخانة، ولا تُحدث الذاكرة الرئيسية إلا لاحقاً عند استبدال تلك الخانة. هذا يسرّع عمليات الكتابة، لكنه قد يؤدي إلى فقدان البيانات إذا تعطل الكاش قبل نقلها إلى الذاكرة الرئيسية.
وأما عند خطأ الكتابة (كتابة إلى عنوان غير موجود في الكاش) فخياران:
• التخصيص عند الكتابة (Write-Allocate): تُحمّل الكتلة من الذاكرة الرئيسية إلى الكاش ثم تكتب فيه.
• الكتابة بدون تخصيص (Write-Around): تكتب مباشرة إلى الذاكرة الرئيسية دون جلب البلوك إلى الكاش. تستخدم عندما نتوقع أن البيانات الجديدة لن يعاد استخدامها قريباً.
معمل عملي: قس الفارق بنفسك
اكتب البرنامج التالي وشغّله ثم قارن الزمنين:
#include <stdio.h>
#include <time.h>
#include <stdlib.h>

#define N 1000000

int main(void) {
    static int A[N];
    for (long i = 0; i < N; i++) A[i] = i;

    clock_t t = clock();
    long sum = 0;
    for (long i = 0; i < N; i++) sum += A[i];           /* متتابع */
    printf("sequential: %ld ms\n", clock() - t);

    t = clock();
    sum = 0;
    for (long i = 0; i < N; i++) sum += A[rand() % N];  /* عشوائي */
    printf("random:     %ld ms\n", clock() - t);
    return 0;
}
شغّله وسجّل النتيجتين، ثم كرر التجربة بزيادة N إلى عشرة ملايين. هل يتسع الفارق أم يتقلص؟ وفكّر: ماذا يحدث للكاش حين تصبح المصفوفة أكبر من سعته مجتمعة؟
هدف المعمل: أن ترى المحلية بأرقام جهازك أنت، لا بأرقام كتاب.
بهذا نكون قد فهمنا كيف يختصر الكاش المسافة بين معالج سريع وذاكرة بطيئة، وكيف تدار هذه الوساطة بالربط والاستبدال والكتابة. نلتقي في الدرس القادم بإذن الله.
خلاصة الدرس
| المفهوم | النقاط الرئيسية |
|---|---|
| الكاش | مخزن SRAM صغير فائق السرعة بين CPU والـ RAM |
| Hit / Miss | الإصابة تعني سرعة قصوى؛ الإخفاق يجلب من الذاكرة ويخزن نسخة |
| AMAT | T(hit) + نسبة الإخفاق × العقوبة |
| المحلية الزمانية | ما استُخدم مؤخراً سيُستخدم قريباً |
| المحلية المكانية | جلب البلوك يجيب العناوين المجاورة |
| الربط | مباشر (سريع/تصادمات) ← مجموعاتي (الحل الذهبي) ← كامل (مرن/باهظ) |
| الاستبدال | LRU فعال لكنه معقد؛ FIFO بسيط أعمى؛ Random أسرع حكماً |
| الكتابة | Write-through اتساق أعلى؛ Write-back سرعة أعلى مع Dirty Bit |
لا تنسونا من صالح دعائكم.